AI Agent Güvenliği: Otonom Yapay Zekâ, Tool Calling ve MCP Riskleri
AI Agent güvenliği nedir? Otonom yapay zekâ ajanlarında MCP, Tool Calling, Prompt Injection, yetki yükseltme, veri sızıntısı ve güvenli mimari yöntemlerini keşfedin.
Giriş: Yapay Zekâ Artık Yalnızca Cevap Vermiyor, İşlem de Gerçekleştiriyor
Yapay zekâ uygulamalarında yeni bir dönem başladı.
İlk nesil kurumsal yapay zekâ uygulamalarının temel görevi bilgi üretmekti.
Kullanıcı bir soru soruyor, model cevap veriyordu.
Bir doküman yükleniyor, model özet hazırlıyordu.
Bir metin gönderiliyor, model çeviri gerçekleştiriyordu.
Bu sistemlerde güvenlik riskleri önemliydi ancak modelin doğrudan gerçekleştirebildiği işlemler çoğunlukla sınırlıydı.
Günümüzde ise yapay zekâ sistemleri giderek daha fazla kurumsal araca bağlanıyor.
E-posta sistemlerine erişebiliyor.
Takvim kayıtları oluşturabiliyor.
CRM uygulamalarından müşteri bilgisi sorgulayabiliyor.
ERP sistemlerinde iş akışları başlatabiliyor.
Veritabanlarından rapor üretebiliyor.
Yazılım geliştirme ortamlarında dosyaları değiştirebiliyor.
Bulut altyapısında belirli yönetim işlemlerini gerçekleştirebiliyor.
Bu dönüşümün merkezinde AI Agent, yani yapay zekâ ajanları bulunuyor.
Bir AI Agent'ın klasik sohbet botundan temel farkı, yalnızca cevap üretmek yerine belirli hedeflere ulaşmak için araç kullanabilmesi ve birden fazla işlem adımını yönetebilmesidir.
Örneğin bir kullanıcı yapay zekâ ajanına şu talimatı verebilir:
“Bu ayın satış raporunu hazırla, geçen ayla karşılaştır ve yöneticime e-posta taslağı oluştur.”
Ajan bu görevi yerine getirmek için farklı işlemler gerçekleştirebilir.
Önce satış verilerine erişir.
Ardından rapor oluşturur.
Geçmiş dönemle karşılaştırma yapar.
Sonuçları özetler.
Son olarak e-posta taslağı hazırlar.
Bu süreç doğru tasarlandığında önemli verimlilik sağlayabilir.
Ancak aynı mimari yeni güvenlik sorumlulukları oluşturur.
Ajan yanlış veriye erişirse ne olur?
Kötü niyetli bir dokümandaki talimatları takip ederse ne olur?
Gereğinden fazla yetkiyle çalışıyorsa ne olur?
Kullanıcının istemediği bir işlemi başlatırsa ne olur?
Bağlı olduğu araçlardan biri ele geçirilirse ne olur?
Bu sorular artık yalnızca yapay zekâ modelinin davranışıyla ilgili değildir.
Doğrudan kurumsal bilgi sistemlerinin güvenliğiyle ilgilidir.
AI Agent güvenliğinde temel hedef, yapay zekânın ne düşündüğünü kontrol etmekten çok, hangi işlemleri hangi yetkilerle gerçekleştirebildiğini güvence altına almaktır.
1. AI Agent Nedir?
AI Agent, belirli bir hedefe ulaşmak için çevresinden bilgi alabilen, mevcut bağlamı değerlendirebilen, uygun araçları kullanabilen ve bir veya daha fazla işlem adımını yürütebilen yapay zekâ tabanlı sistemdir.
Her AI Agent aynı düzeyde otonom değildir.
Bazı ajanlar yalnızca öneri üretir.
Bazıları kullanıcı onayıyla işlem gerçekleştirir.
Bazıları ise önceden tanımlanmış sınırlar içerisinde otomatik çalışabilir.
Bu nedenle AI Agent kavramını yalnızca tamamen bağımsız çalışan sistemlerle sınırlandırmak doğru değildir.
AI Agent'ın temel bileşenleri
Bir yapay zekâ ajanı genel olarak şu bileşenlerden oluşabilir:
Model: Kullanıcı talebini yorumlar, bilgi üretir ve sonraki işlem için öneriler oluşturur.
Talimatlar: Ajanın görevini, davranış sınırlarını ve çalışma kurallarını tanımlar.
Araçlar: Harici sistemlerle etkileşim kurmasını sağlar.
Bağlam: Kullanıcı mesajları, dokümanlar, geçmiş işlemler ve diğer ilgili bilgileri içerir.
Orkestrasyon katmanı: Model çağrılarını, araç kullanımını ve iş akışlarını yönetir.
Güvenlik kontrolleri: Kimlik doğrulama, yetkilendirme, onay, veri koruma ve denetim işlevlerini uygular.
Bu bileşenlerin tamamı güvenlik açısından değerlendirilmelidir.
Çünkü güvenlik problemi yalnızca modelin ürettiği metinden kaynaklanmayabilir.
Ajanın bağlı olduğu bir API veya yanlış yapılandırılmış servis hesabı da ciddi risk oluşturabilir.
2. AI Agent ile Geleneksel Chatbot Arasındaki Fark
Geleneksel chatbot sistemleri çoğunlukla kullanıcıya bilgi sunmak için kullanılır.
AI Agent sistemleri ise bilgi üretiminin ötesinde işlem gerçekleştirebilir.
| Özellik | Geleneksel Chatbot | AI Agent |
|---|---|---|
| Temel işlev | Soru cevaplama | Hedefe yönelik görev yürütme |
| Araç kullanımı | Olmayabilir veya sınırlıdır | Temel yeteneklerden biri olabilir |
| Çok adımlı işlem | Genellikle sınırlı | Birden fazla adımı yönetebilir |
| Veri erişimi | Bilgi kaynakları | Bilgi kaynakları ve işlem servisleri |
| Otonomi | Düşük veya sınırlı | Tasarıma göre değişken |
| Güvenlik etkisi | Çoğunlukla bilgi ve çıktı | Bilgi, veri değişikliği ve operasyon |
| Kritik kontrol | Veri erişimi ve çıktı güvenliği | Bunlara ek olarak işlem yetkilendirmesi |
Bu ayrım önemlidir.
Çünkü bir chatbot'un yanlış cevap vermesiyle bir AI Agent'ın yanlış işlem gerçekleştirmesi aynı etkiye sahip değildir.
Örneğin müşteri destek chatbot'unun yanlış ürün bilgisi vermesi müşteri memnuniyetini etkileyebilir.
Ancak müşteri destek ajanının yanlış müşteri kaydını değiştirmesi doğrudan veri bütünlüğü problemi oluşturabilir.
Bu nedenle AI Agent güvenliği, geleneksel LLM güvenliğinden daha geniş bir işlem güvenliği yaklaşımı gerektirir.
3. Agentic AI Nedir?
Agentic AI, yapay zekâ sistemlerinin belirli hedeflere ulaşmak için planlama, araç kullanımı ve çok adımlı görev yürütme gibi ajan benzeri yeteneklerle çalışmasını ifade eder.
Bu yaklaşımda model yalnızca tek bir soruya cevap vermekle sınırlı olmayabilir.
Örneğin kullanıcı şu görevi verebilir:
“Geçen ayın açık destek taleplerini analiz et, en sık karşılaşılan problemleri belirle ve yönetim için rapor hazırla.”
Ajan bu görevi alt adımlara ayırabilir.
Destek taleplerini sorgular.
Verileri sınıflandırır.
İstatistik oluşturur.
Raporu hazırlar.
Sonuçları kullanıcıya sunar.
Ancak her yeni adım yeni bir güvenlik değerlendirmesi gerektirebilir.
Örneğin destek taleplerini okumak için gerekli yetki, müşteri kayıtlarını değiştirme yetkisinden farklıdır.
Bu nedenle Agentic AI mimarilerinde görev planlaması ile işlem yetkilendirmesi birbirinden ayrılmalıdır.
Model bir iş akışı planlayabilir; ancak güvenlik politikalarını değiştirme yetkisine sahip olmamalıdır.
4. AI Agent Güvenliği Nedir?
AI Agent güvenliği, yapay zekâ ajanlarının kullandığı veri kaynaklarının, araçların, işlem yetkilerinin ve çalışma süreçlerinin güvenlik risklerine karşı korunmasıdır.
Bu kapsamda hem geleneksel siber güvenlik riskleri hem de yapay zekâya özgü tehditler değerlendirilir.
Örneğin:
- Yetkisiz veri erişimi.
- Aşırı yetkilendirme.
- Prompt Injection.
- Güvensiz araç çağrıları.
- MCP entegrasyon riskleri.
- Hassas veri sızıntısı.
- Kontrolsüz işlem zincirleri.
- Araç çıktılarının manipülasyonu.
- Kimlik bilgisi güvenliği.
- Denetim ve izlenebilirlik eksikliği.
AI Agent güvenliğinin temelinde üç soru bulunur:
Ajan neye erişebilir?
Ajan ne yapabilir?
Ajanın gerçekleştirdiği işlemler nasıl kontrol edilir?
Bu soruların cevapları güvenilir uygulama ve altyapı kontrolleriyle uygulanmalıdır.
5. Tool Calling Nedir?
Tool Calling, bir yapay zekâ modelinin uygulama tarafından tanımlanan fonksiyonları kullanmak üzere yapılandırılmış çağrılar önermesini sağlayan mekanizmadır.
Örneğin bir kurumun müşteri yönetim sistemiyle entegre çalışan AI Agent'ı olabilir.
Kullanıcı şu soruyu sorar:
“ABC müşterisinin son üç siparişini getir.”
Model, ilgili müşteri bilgilerini almak için tanımlanmış bir araç çağrısı oluşturabilir.
Örneğin kavramsal olarak:
{
"tool": "get_customer_orders",
"arguments": {
"customer_id": "ABC"
}
}
Bu örnekte model, get_customer_orders aracının kullanılmasını önermektedir.
Ancak önemli bir ayrım vardır.
Modelin araç çağrısı üretmesi, aracın mutlaka çalıştırılması gerektiği anlamına gelmez.
Uygulama katmanı isteği değerlendirmelidir.
Kullanıcının kimliğini doğrulamalıdır.
İlgili müşteri kaydına erişim yetkisini kontrol etmelidir.
Parametreleri doğrulamalıdır.
Ardından işlem politikasına göre karar vermelidir.
Tool Calling güvenliğinde modelin önerisi ile uygulamanın işlem izni birbirinden ayrılmalıdır.
6. Tool Calling Güvenlik Riskleri
Tool Calling mekanizmaları farklı güvenlik riskleri oluşturabilir.
Yetkisiz araç kullanımı
Modelin, kullanıcının erişim yetkisi olmayan bir aracı çağırması hedeflenebilir.
Örneğin standart kullanıcının yönetici fonksiyonunu çalıştırması istenebilir.
Hatalı parametre kullanımı
Model, araç çağrısına yanlış veya beklenmeyen parametreler gönderebilir.
Bu durum veri bütünlüğü veya iş mantığı problemlerine yol açabilir.
Aşırı yetkilendirme
Araç, gerekli olandan daha geniş erişim yetkilerine sahip olabilir.
Güvensiz çıktı işleme
Araçtan dönen veri, model veya uygulama tarafından güvenli olmayan biçimde işlenebilir.
Denetim eksikliği
Araç çağrıları kayıt altına alınmıyorsa olayların incelenmesi zorlaşabilir.
Bu riskler yalnızca model seviyesinde çözülemez.
Uygulama, API ve altyapı kontrolleri birlikte uygulanmalıdır.
7. Excessive Agency: Aşırı Yetkilendirilmiş Yapay Zekâ Ajanları
Excessive Agency, bir yapay zekâ ajanına görevini yerine getirmek için ihtiyaç duyduğundan daha fazla işlem yetkisi verilmesiyle ilişkili güvenlik riskidir.
Örneğin bir AI Agent'ın görevi yalnızca müşteri siparişlerini görüntülemek olabilir.
Ancak ajan aynı zamanda sipariş iptal etme ve müşteri bilgilerini değiştirme yetkisine sahipse gereksiz risk oluşur.
Örnek senaryo
Bir finans kuruluşunda raporlama asistanı kullanıldığını düşünelim.
Asistanın görevi finansal verileri sorgulamak ve rapor hazırlamaktır.
Ancak veritabanı bağlantısı geniş yetkili bir hesapla yapılandırılmıştır.
Bu hesap veri okumanın yanında veri değiştirme işlemlerini de gerçekleştirebilir.
Bu durumda modelin hatalı bir araç çağrısı önermesi daha ciddi sonuçlar oluşturabilir.
Korunma yaklaşımı
Okuma ve yazma yetkileri ayrılmalıdır.
Ajanın görevine özel servis hesapları kullanılmalıdır.
Kritik işlemler için ayrı yetkilendirme uygulanmalıdır.
Gereksiz araçlar ajan ortamından kaldırılmalıdır.
Ajan yetkileri düzenli olarak gözden geçirilmelidir.
Bu yaklaşım en az yetki prensibinin AI Agent mimarilerine uygulanmasıdır.
8. AI Agent ve Least Privilege
Least Privilege, yani en az yetki prensibi, kullanıcıların ve sistemlerin yalnızca görevleri için gerekli yetkilere sahip olmasını hedefler.
AI Agent sistemlerinde bu prensip özellikle önemlidir.
Çünkü ajanlar birden fazla araca erişebilir.
Örneğin bir ajan:
CRM sistemine bağlanabilir.
E-posta servisini kullanabilir.
Doküman yönetim sisteminden bilgi alabilir.
Raporlama API'sini çağırabilir.
Bu araçların tamamına geniş yetki verilmesi gereksiz risk oluşturur.
Görev bazlı yetkilendirme
Bir raporlama ajanına yalnızca okuma yetkisi verilebilir.
Bir destek ajanına yalnızca destek kaydı oluşturma yetkisi tanımlanabilir.
Bir takvim ajanına yalnızca belirli takvimlerde işlem yapma izni verilebilir.
Bu yaklaşım saldırı veya model hatası durumunda olası etkiyi sınırlandırabilir.
9. MCP Nedir?
MCP, Model Context Protocol ifadesinin kısaltmasıdır.
Model Context Protocol, yapay zekâ uygulamalarının dış veri kaynakları ve araçlarla standartlaştırılmış biçimde etkileşim kurmasını kolaylaştıran açık bir protokoldür.
MCP, farklı yapay zekâ uygulamalarının çeşitli sistemlerle entegrasyonunu daha düzenli hale getirebilir.
Örneğin bir AI uygulaması MCP üzerinden:
Dosya sistemine erişebilir.
Kurumsal bilgi kaynaklarını sorgulayabilir.
Veritabanı araçlarını kullanabilir.
Geliştirme araçlarına bağlanabilir.
İş uygulamalarıyla etkileşim kurabilir.
Ancak entegrasyon kolaylığı güvenlik gereksinimlerini ortadan kaldırmaz.
Tam tersine, daha fazla araç ve veri kaynağı kullanıldığında güvenlik sınırlarının açık şekilde tanımlanması gerekir.
10. MCP Mimarisi Nasıl Çalışır?
MCP mimarisinde farklı bileşenler bulunur.
Genel olarak:
MCP Host: Yapay zekâ deneyimini sunan uygulamadır.
MCP Client: MCP sunucusuyla protokol iletişimini yürüten bileşendir.
MCP Server: Araç, kaynak veya diğer desteklenen yetenekleri sunan bileşendir.
Örneğin bir masaüstü yapay zekâ uygulaması, MCP istemcisi aracılığıyla kurumsal doküman sistemine bağlı bir MCP sunucusundan bilgi alabilir.
Bu mimaride güvenlik açısından şu sorular önemlidir:
MCP sunucusu güvenilir mi?
İstemci hangi kimlikle bağlanıyor?
Hangi araçlar kullanılabiliyor?
Veri erişimi nasıl sınırlandırılıyor?
Araç çıktıları nasıl işleniyor?
Kimlik bilgileri nasıl korunuyor?
Bu sorular cevaplanmadan yalnızca MCP desteği bulunması güvenli entegrasyon anlamına gelmez.
11. MCP Güvenliği Nedir?
MCP güvenliği, MCP üzerinden sunulan araçların, veri kaynaklarının, kimlik doğrulama mekanizmalarının ve işlem yetkilerinin güvenli şekilde yönetilmesidir.
MCP bir entegrasyon protokolüdür.
Tek başına bütün uygulama güvenliği problemlerini çözmez.
Örneğin MCP sunucusu bir veritabanı sorgulama aracı sunabilir.
Ancak bu aracın hangi kullanıcı tarafından hangi kayıtlar üzerinde kullanılabileceği ayrıca kontrol edilmelidir.
Benzer şekilde MCP sunucusunun güvenilir olması, sunulan bütün araçların sınırsız yetkiyle kullanılabileceği anlamına gelmez.
MCP güvenliğinde temel alanlar
Sunucu güvenilirliği.
Kimlik doğrulama.
Yetkilendirme.
Araç erişim kontrolü.
Veri güvenliği.
İşlem denetimi.
Güvenli iletişim.
Tedarik zinciri güvenliği.
Bu kontroller birlikte değerlendirilmelidir.
12. Kötü Niyetli MCP Sunucusu Riski
Bir yapay zekâ uygulaması farklı MCP sunucularına bağlanabilir.
Bu sunucuların tamamı aynı güvenilirlik seviyesinde olmayabilir.
Örneğin kurum dışarıdan temin edilen bir MCP entegrasyonunu kullanmak isteyebilir.
Ancak entegrasyonun kaynağı, kodu ve erişim yetkileri yeterince incelenmemiş olabilir.
Bu durumda güvenlik riski oluşur.
Olası riskler
MCP sunucusu beklenenden fazla veri isteyebilir.
Araç açıklamaları manipülatif içerikler barındırabilir.
Araç çıktıları güvenilmeyen talimatlar içerebilir.
Sunucu hassas bilgileri uygun olmayan hedeflere aktarabilir.
Korunma yaklaşımı
MCP sunucuları güvenilir kaynaklardan temin edilmelidir.
Entegrasyonlar güvenlik değerlendirmesinden geçirilmelidir.
Gereksiz araçlar etkinleştirilmemelidir.
Ağ erişimi sınırlandırılmalıdır.
Kimlik bilgileri güvenli şekilde yönetilmelidir.
MCP sunucusunun hangi verilere erişebildiği açıkça belirlenmelidir.
13. Tool Description Poisoning
Tool Description Poisoning, yapay zekâ ajanına sunulan araç açıklamalarının manipüle edilerek model davranışının etkilenmesini hedefleyen saldırı yaklaşımıdır.
Bir AI Agent, hangi aracın ne işe yaradığını anlamak için araç açıklamalarından yararlanabilir.
Örneğin bir araç açıklamasında:
“Bu araç müşteri siparişlerini sorgular.”
ifadesi bulunabilir.
Ancak saldırgan tarafından kontrol edilen araç açıklaması, modelin davranışını değiştirmeyi hedefleyen ek talimatlar içerebilir.
Bu durumda araç açıklaması yalnızca teknik metadata olmaktan çıkarak Prompt Injection yüzeyi haline gelebilir.
Güvenlik prensibi
Araç açıklamaları güvenilir kaynaklardan alınmalıdır.
Araçların yetkileri açıklama metnine göre değil, uygulama politikalarına göre belirlenmelidir.
Yeni veya değiştirilen araçlar güvenlik değerlendirmesine tabi tutulmalıdır.
Bu risk özellikle dinamik araç keşfi kullanan AI Agent sistemlerinde önemlidir.
14. Tool Output Poisoning
Tool Output Poisoning, bir aracın döndürdüğü verilerin manipüle edilerek model davranışının etkilenmesini hedefleyen saldırı yaklaşımıdır.
Örneğin AI Agent bir web sayfasını okumak için araç kullanabilir.
Araç sayfa içeriğini modele döndürür.
Ancak içerik saldırgan tarafından kontrol ediliyor olabilir.
Model bu içeriği yalnızca bilgi olarak değerlendirmek yerine talimat gibi yorumlarsa güvenlik problemi oluşabilir.
Örnek senaryo
Bir ajan, ürün fiyatlarını karşılaştırmak için harici kaynaklardan veri toplamaktadır.
Saldırganın kontrol ettiği bir veri kaynağı, fiyat bilgileriyle birlikte modelin değerlendirme yöntemini değiştirmeyi hedefleyen talimatlar içerir.
Bu durumda modelin ürettiği karşılaştırma sonucu manipüle edilebilir.
Korunma yaklaşımı
Araç çıktıları güvenilmeyen veri olarak değerlendirilmelidir.
Kritik kararlar mümkün olduğunca yapılandırılmış veri ve bağımsız kurallarla doğrulanmalıdır.
Araç çıktılarının yeni işlem yetkisi oluşturmasına izin verilmemelidir.
15. AI Agent Sistemlerinde Prompt Injection
Prompt Injection, AI Agent güvenliğinin önemli tehditlerinden biridir.
Çünkü saldırganın kontrol ettiği içerikler modelin davranışını etkileyebilir.
Örneğin:
Müşteri destek mesajı.
PDF dokümanı.
Web sayfası.
E-posta.
Repository dosyası.
MCP araç çıktısı.
Bu içeriklerin tamamı potansiyel saldırı yüzeyi olabilir.
AI Agent üzerinde neden daha yüksek risk oluşturabilir?
Klasik chatbot yalnızca yanlış cevap üretebilir.
Ancak AI Agent bağlı araçlar üzerinden işlem gerçekleştirebilir.
Bu nedenle model davranışının manipüle edilmesi gerçek sistem etkisine dönüşebilir.
Temel savunma
Güvenilmeyen içeriklerin talimat yetkisi kazanması sınırlandırılmalıdır.
Araç çağrıları bağımsız olarak doğrulanmalıdır.
Ajan yetkileri görev bazlı sınırlandırılmalıdır.
Kritik işlemler için onay mekanizmaları uygulanmalıdır.
16. AI Agent ve Yetkisiz Veri Erişimi
AI Agent sistemleri farklı veri kaynaklarına erişebilir.
Ancak bütün kullanıcıların bütün verilere erişim yetkisi bulunmayabilir.
Örneğin bir kurumun yapay zekâ asistanı CRM sistemine bağlı olabilir.
Satış çalışanları kendi müşteri kayıtlarını görüntüleyebilir.
Bölge yöneticileri belirli ekiplerin kayıtlarına erişebilir.
Üst yönetim ise daha geniş raporlara ulaşabilir.
Bu durumda AI Agent'ın veri erişimi kullanıcının gerçek yetkileriyle uyumlu olmalıdır.
Güvenlik problemi
Ajan geniş yetkili bir servis hesabıyla bütün müşteri kayıtlarını sorgulayabiliyor olabilir.
Uygulama kullanıcı bazlı yetkilendirme uygulamıyorsa veri sızıntısı riski oluşabilir.
Güvenli yaklaşım
Kullanıcı kimliği doğrulanmalıdır.
Veri erişimi kullanıcı yetkilerine göre sınırlandırılmalıdır.
Tenant izolasyonu uygulanmalıdır.
Ajanın kullandığı servis hesabı en az yetki prensibine uygun olmalıdır.
Kritik veri erişimleri kayıt altına alınmalıdır.
17. Confused Deputy Problemi ve AI Agent
Confused Deputy, bir sistemin sahip olduğu yetkilerin başka bir tarafın yönlendirmesiyle uygunsuz biçimde kullanılmasını ifade eden güvenlik problemidir.
AI Agent sistemlerinde bu risk önemlidir.
Çünkü ajan, kullanıcıdan veya harici içeriklerden gelen talepleri yorumlayarak kendi araç yetkileriyle işlem gerçekleştirebilir.
Örneğin bir ajan geniş yetkili bir kurumsal hesaba sahip olabilir.
Saldırgan ise doğrudan bu hesaba erişemeyebilir.
Ancak ajanı manipüle ederek hesabın yetkilerini uygunsuz biçimde kullandırmayı hedefleyebilir.
Korunma yaklaşımı
Ajanın sahip olduğu teknik yetkiler ile kullanıcının iş yetkileri ayrı değerlendirilmelidir.
İşlem öncesinde gerçek kullanıcı bağlamı doğrulanmalıdır.
Araç erişimleri görev bazlı sınırlandırılmalıdır.
Kritik işlemler bağımsız politika kontrollerinden geçmelidir.
Bu yaklaşım AI Agent sistemlerinde yetki kötüye kullanımını azaltmaya yardımcı olur.
18. Human-in-the-Loop Nedir?
Human-in-the-Loop, belirli yapay zekâ işlemlerinde insan değerlendirmesi veya onayının sürece dahil edilmesidir.
AI Agent sistemlerinde özellikle yüksek etkili işlemler için önemli bir kontroldür.
Örneğin:
Rapor oluşturma.
E-posta taslağı hazırlama.
Takvim önerisi sunma.
gibi işlemler düşük riskli olabilir.
Ancak:
Para transferi.
Müşteri verisi silme.
Kullanıcı yetkisi değiştirme.
Toplu e-posta gönderme.
Production sisteminde yapılandırma değiştirme.
gibi işlemler daha yüksek risk taşır.
Bu nedenle kritik işlemler için insan onayı gerekebilir.
İnsan onayı nasıl uygulanmalıdır?
Kullanıcıya işlemin ne yapacağı açık şekilde gösterilmelidir.
İşlemin etkileyeceği veri ve sistemler belirtilmelidir.
Kritik parametreler doğrulanmalıdır.
Onay kayıt altına alınmalıdır.
Ancak insan onayı da tek başına yeterli değildir.
Onay sonrası gerçekleştirilen işlemin onaylanan kapsamla uyumlu olması gerekir.
19. AI Agent İşlem Zincirlerinde Güvenlik
AI Agent sistemleri birden fazla aracı ardışık biçimde kullanabilir.
Örneğin:
CRM'den müşteri bilgisi alınır.
Finans sisteminden ödeme durumu sorgulanır.
Destek sisteminden açık talepler getirilir.
Rapor oluşturulur.
E-posta taslağı hazırlanır.
Bu süreçte her adım farklı veri ve yetki gereksinimlerine sahip olabilir.
Güvenlik riski
Bir adımda elde edilen güvenilmeyen içerik sonraki adımları etkileyebilir.
Örneğin müşteri kaydındaki açıklama alanı modelin sonraki araç seçimini manipüle etmeyi hedefleyebilir.
Korunma yaklaşımı
Her araç çağrısı ayrı değerlendirilmelidir.
İşlem zincirinin toplam yetki kapsamı kontrol edilmelidir.
Güvenilmeyen içerikler sonraki adımlarda talimat olarak kullanılmamalıdır.
Kritik işlemler için ek doğrulama uygulanmalıdır.
Bu yaklaşım çok adımlı ajan sistemlerinde önemlidir.
20. Multi-Agent Sistemlerinde Güvenlik
Multi-Agent mimarilerinde birden fazla yapay zekâ ajanı birlikte çalışabilir.
Örneğin:
Bir ajan veri toplar.
Başka bir ajan analiz yapar.
Üçüncü ajan rapor oluşturur.
Dördüncü ajan sonuçları ilgili sisteme aktarır.
Bu yapı görevlerin ayrıştırılmasını sağlayabilir.
Ancak güvenlik açısından yeni sorular oluşturur.
Ajanlar birbirlerine hangi bilgileri aktarabilir?
Bir ajanın ürettiği talimat diğer ajan için ne kadar güvenilirdir?
Ajanlar aynı servis hesabını mı kullanıyor?
Hangi ajan hangi işlemden sorumludur?
Güvenlik yaklaşımı
Ajanlar arasında açık güven sınırları tanımlanmalıdır.
Her ajan yalnızca gerekli araçlara erişmelidir.
Ajanlar arası mesajlar güvenlik açısından değerlendirilmelidir.
Kritik işlemlerin sorumluluğu ve denetim kayıtları belirlenmelidir.
Bir ajanın ürettiği içerik diğer ajan için otomatik olarak yüksek güven seviyesinde kabul edilmemelidir.
21. AI Agent Kimlik Bilgisi Güvenliği
AI Agent sistemleri çeşitli servislerle bağlantı kurmak için kimlik bilgileri kullanabilir.
Örneğin:
API key.
OAuth token.
Servis hesabı.
Veritabanı bağlantı bilgisi.
Bulut erişim kimliği.
Bu bilgilerin güvenliği kritik önem taşır.
Riskler
Credential bilgilerinin kaynak kodda tutulması.
Token'ların loglara yazılması.
Ajanın gereksiz geniş erişim yetkisiyle çalışması.
Kimlik bilgilerinin harici model bağlamına aktarılması.
Uzun ömürlü erişim anahtarlarının kontrolsüz kullanılması.
Korunma yaklaşımı
Merkezi secrets management kullanılmalıdır.
Mümkün olduğunda kısa ömürlü kimlik bilgileri tercih edilmelidir.
Servis hesapları en az yetki prensibine göre yapılandırılmalıdır.
Credential erişimleri izlenmelidir.
Kimlik bilgileri model prompt'una gereksiz biçimde dahil edilmemelidir.
22. AI Agent Sistemlerinde Veri Sızıntısı
AI Agent sistemleri farklı kurumsal veri kaynaklarına erişebilir.
Bu nedenle veri sızıntısı riski yalnızca modelin cevaplarında ortaya çıkmaz.
Örneğin ajan bir dokümanı harici servise gönderebilir.
Bir raporu yanlış alıcıya iletebilir.
Bir API aracılığıyla gereğinden fazla veri çekebilir.
Veya hassas bilgileri loglara yazabilir.
Veri sızıntısını azaltma yöntemleri
Veri minimizasyonu uygulanmalıdır.
Ajanın erişebileceği veri kaynakları sınırlandırılmalıdır.
Harici veri aktarımı kontrol edilmelidir.
Hassas bilgiler uygun durumlarda maskelenmelidir.
Kritik veri işlemleri kayıt altına alınmalıdır.
Bu kontroller AI Agent güvenliğinin temel bileşenleridir.
23. AI Agent ve Denetim Kayıtları
AI Agent sistemlerinde audit logging, yani denetim kayıtları, güvenlik ve hesap verebilirlik açısından önemlidir.
Çünkü bir ajan çok sayıda işlem gerçekleştirebilir.
Örneğin müşteri kaydı sorgulayabilir.
Dosya oluşturabilir.
E-posta taslağı hazırlayabilir.
İş akışı başlatabilir.
Bu işlemlerin hangi kullanıcı adına ve hangi yetkiyle gerçekleştirildiğinin bilinmesi gerekir.
Audit log içerisinde bulunabilecek bilgiler
İşlemi başlatan kullanıcı.
Ajan kimliği.
Kullanılan araç.
İşlem zamanı.
İşlem sonucu.
Onay durumu.
Güvenlik politikası kararı.
Ancak loglama sırasında hassas verilerin gereksiz biçimde saklanmamasına dikkat edilmelidir.
Güvenli loglama, izlenebilirlik ile veri minimizasyonu arasında uygun denge kurmalıdır.
24. AI Agent Güvenliğinde Rate Limiting ve İşlem Limitleri
AI Agent sistemleri çok sayıda araç çağrısı gerçekleştirebilir.
Bu durum kaynak tüketimi ve maliyet açısından risk oluşturabilir.
Örneğin hatalı yapılandırılmış bir ajan aynı API'yi tekrar tekrar çağırabilir.
Bir işlem döngüsü beklenenden uzun sürebilir.
Harici model kullanımı maliyetleri artabilir.
Korunma yöntemleri
Araç çağrısı sayısı sınırlandırılmalıdır.
İşlem zaman aşımı tanımlanmalıdır.
Kullanıcı ve ajan bazlı kota uygulanmalıdır.
Maliyet limitleri belirlenmelidir.
Beklenmeyen işlem döngüleri izlenmelidir.
Bu kontroller hem güvenlik hem de operasyonel sürdürülebilirlik açısından önemlidir.
25. AI Agent Güvenliğinde Sandbox Kullanımı
Sandbox, uygulama veya işlemlerin belirli sınırlar içerisinde çalıştırıldığı izole ortamdır.
AI Coding Agent ve benzeri sistemlerde sandbox kullanımı önemli bir güvenlik kontrolü olabilir.
Örneğin bir coding agent test çalıştırmak için terminal komutu kullanabilir.
Bu komutların doğrudan production sunucusunda çalıştırılması gereksiz risk oluşturur.
Bunun yerine ajan izole geliştirme ortamında çalıştırılabilir.
Sandbox güvenlik kontrolleri
Dosya sistemi erişimi sınırlandırılmalıdır.
Ağ erişimi kontrol edilmelidir.
Hassas credential'lar ortamdan uzak tutulmalıdır.
Kaynak tüketimi sınırlandırılmalıdır.
Çalışma ortamı düzenli olarak yenilenmelidir.
Ancak sandbox kullanılması bütün risklerin ortadan kalktığı anlamına gelmez.
Sandbox yapılandırmasının kendisi de güvenlik değerlendirmesine ihtiyaç duyar.
26. AI Agent Security Testing Nedir?
AI Agent Security Testing, yapay zekâ ajanlarının veri erişimi, araç kullanımı, yetkilendirme ve işlem güvenliği açısından değerlendirilmesidir.
Bu testler yalnızca modelin verdiği cevapları incelemekten daha geniş kapsamlıdır.
Test alanları
Prompt Injection.
Tool Calling güvenliği.
MCP entegrasyonları.
Aşırı yetkilendirme.
Yetkisiz veri erişimi.
Credential güvenliği.
Güvensiz çıktı işleme.
İşlem zinciri manipülasyonu.
Denetim kayıtları.
Test metodolojisi
Öncelikle ajan mimarisi anlaşılmalıdır.
Ardından veri kaynakları ve araçlar belirlenmelidir.
Güven sınırları tanımlanmalıdır.
Risk bazlı saldırı senaryoları hazırlanmalıdır.
Bulguların gerçek sistem etkisi doğrulanmalıdır.
Son olarak düzeltme ve retest gerçekleştirilmelidir.
27. MCP Security Testing
MCP entegrasyonları kullanan AI Agent sistemlerinde özel güvenlik değerlendirmeleri yapılabilir.
Örneğin:
MCP sunucusunun güvenilirliği.
Kimlik doğrulama mekanizması.
Araç yetkilendirmesi.
Araç açıklamalarının güvenliği.
Araç çıktılarının işlenmesi.
Veri erişim kapsamı.
Kimlik bilgisi yönetimi.
Ağ güvenliği.
Bu kontrollerin her biri entegrasyonun mimarisine göre değerlendirilmelidir.
Örneğin yerel dosya sistemine erişen bir MCP sunucusunun riskleri ile harici SaaS API'sine bağlanan bir MCP sunucusunun riskleri farklı olabilir.
Bu nedenle MCP güvenliği tek bir kontrol listesiyle sınırlı kalmamalıdır.
28. Örnek Senaryo: Kurumsal CRM AI Agent'ı
Bir kurumun CRM sistemi üzerinde çalışan yapay zekâ ajanı geliştirdiğini düşünelim.
Ajanın görevleri şunlardır:
Müşteri kayıtlarını sorgulamak.
Açık fırsatları listelemek.
Satış raporu hazırlamak.
Toplantı notlarını özetlemek.
İlk aşamada ajan yalnızca okuma yetkisine sahiptir.
Daha sonra yeni özellikler eklenir.
Müşteri kaydı güncelleme.
Fırsat aşaması değiştirme.
E-posta taslağı oluşturma.
Bu noktada güvenlik riskleri artar.
Risk 1: Yetkisiz müşteri erişimi
Ajan başka satış temsilcisine ait müşteri kayıtlarını görüntüleyebilir.
Risk 2: Prompt Injection
CRM açıklama alanındaki kötü niyetli içerik ajan davranışını etkileyebilir.
Risk 3: Aşırı yetkilendirme
Ajan gereksiz şekilde müşteri kaydı silme yetkisine sahip olabilir.
Risk 4: Hatalı işlem
Model yanlış fırsat kaydını güncellemeyi önerebilir.
Risk 5: Denetim eksikliği
Ajanın hangi müşteri kaydını değiştirdiği izlenemeyebilir.
Güvenli mimari
Kullanıcı bazlı yetkilendirme uygulanmalıdır.
Araç yetkileri sınırlandırılmalıdır.
Kritik veri değişiklikleri için onay mekanizması değerlendirilmelidir.
Araç çağrıları kayıt altına alınmalıdır.
Prompt Injection ve yetkilendirme testleri yapılmalıdır.
Bu örnek AI Agent güvenliğinin yalnızca model davranışı değil, kurumsal işlem güvenliği olduğunu gösterir.
29. SECURESYS AI Agent Güvenliği Yaklaşımı
SECURESYS olarak AI Agent güvenliğinin geleneksel uygulama güvenliği, API güvenliği ve yapay zekâ güvenliği kontrollerinin birlikte uygulanmasını gerektirdiğini değerlendiriyoruz.
Çünkü AI Agent sistemleri yalnızca bilgi üretmez.
Kurumsal sistemlere bağlanabilir.
Veri okuyabilir.
İşlem başlatabilir.
Ve belirli yetkilerle operasyonel süreçleri etkileyebilir.
Bu nedenle güvenlik değerlendirmesi model davranışının ötesine geçmelidir.
Proje kapsamına göre aşağıdaki alanlar birlikte ele alınabilir:
AI Agent Security Assessment
Ajan mimarisinin, veri erişimlerinin ve işlem yetkilerinin değerlendirilmesi.
Tool Calling Security Testing
Araç çağrılarının yetkilendirme, parametre doğrulama ve işlem güvenliği açısından incelenmesi.
MCP Security Assessment
MCP sunucularının, araç açıklamalarının ve entegrasyon güvenliğinin değerlendirilmesi.
Prompt Injection Testing
Güvenilmeyen içeriklerin ajan davranışına etkisinin test edilmesi.
API Security Testing
Ajanın bağlı olduğu servislerin authentication ve authorization kontrollerinin değerlendirilmesi.
Data Leakage Assessment
Hassas veri erişimi ve aktarım risklerinin incelenmesi.
AI Gateway Architecture
Merkezi politika, veri koruma ve araç kullanım kontrollerinin tasarlanması.
AI Red Teaming
Gerçekçi saldırı senaryolarıyla ajan sisteminin güvenlik dayanıklılığının değerlendirilmesi.
Bu yaklaşımda temel hedef yalnızca modelin yanlış karar vermesini önlemek değildir.
Modelin yanlış karar vermesi durumunda da sistemin güvenlik sınırlarının korunmasını sağlamaktır.
Özellikle kurumsal AI Agent uygulamalarında:
Ajanın yapabilecekleri, kullanıcı ve sistem politikaları tarafından açık şekilde sınırlandırılmalıdır.
30. AI Agent Güvenliği Kontrol Listesi
Mimari güvenlik
- Ajan mimarisi dokümante edildi mi?
- Kullanılan modeller ve araçlar envantere alındı mı?
- Veri kaynakları belirlendi mi?
- Güven sınırları tanımlandı mı?
Yetkilendirme
- Kullanıcı kimliği doğrulanıyor mu?
- Araç erişimleri görev bazlı sınırlandırıldı mı?
- En az yetki prensibi uygulanıyor mu?
- Kritik işlemler bağımsız yetkilendirmeden geçiyor mu?
MCP güvenliği
- MCP sunucuları güvenilir kaynaklardan mı?
- MCP araç yetkileri değerlendirildi mi?
- Araç açıklamaları ve çıktıları güvenlik açısından incelendi mi?
- Kimlik bilgileri güvenli şekilde yönetiliyor mu?
Veri güvenliği
- Hassas veriler sınıflandırıldı mı?
- Gereksiz veri erişimi engelleniyor mu?
- Harici veri aktarımı kontrol ediliyor mu?
- Tenant izolasyonu sağlanıyor mu?
İşlem güvenliği
- Kritik işlemler için onay mekanizması var mı?
- Araç çağrıları kayıt altına alınıyor mu?
- İşlem limitleri tanımlandı mı?
- Hatalı işlem zincirleri izleniyor mu?
Güvenlik testleri
- Prompt Injection test edildi mi?
- Tool Calling güvenliği değerlendirildi mi?
- MCP Security Testing yapıldı mı?
- Yetkisiz veri erişimi test edildi mi?
- Kritik bulgular için retest gerçekleştirildi mi?
Bu kontrol listesi kurumun AI Agent kullanım senaryosuna göre genişletilebilir.
Sık Sorulan Sorular
AI Agent nedir?
AI Agent, belirli hedeflere ulaşmak için bilgi toplayabilen, araç kullanabilen ve çok adımlı görevleri gerçekleştirebilen yapay zekâ tabanlı sistemdir.
AI Agent güvenliği nedir?
AI Agent güvenliği, yapay zekâ ajanlarının veri erişimlerinin, araç kullanımının, işlem yetkilerinin ve çalışma süreçlerinin güvenli biçimde yönetilmesidir.
Agentic AI nedir?
Agentic AI, yapay zekâ sistemlerinin planlama, araç kullanımı ve çok adımlı görev yürütme gibi ajan benzeri yeteneklerle çalışmasını ifade eder.
Tool Calling nedir?
Tool Calling, modelin uygulama tarafından tanımlanan fonksiyonları kullanmak üzere yapılandırılmış çağrılar önermesini sağlayan mekanizmadır.
MCP nedir?
MCP, Model Context Protocol ifadesinin kısaltmasıdır. Yapay zekâ uygulamalarının dış veri kaynakları ve araçlarla standartlaştırılmış biçimde etkileşim kurmasını kolaylaştırır.
MCP güvenliği neden önemlidir?
MCP entegrasyonları yapay zekâ sistemlerine yeni veri ve işlem erişimleri sağlayabilir. Bu nedenle kimlik doğrulama, yetkilendirme ve araç güvenliği önemlidir.
Excessive Agency nedir?
Excessive Agency, yapay zekâ ajanına görevini yerine getirmek için gerekli olandan daha geniş işlem yetkileri verilmesiyle ilişkili güvenlik riskidir.
Tool Description Poisoning nedir?
Araç açıklamalarının manipüle edilerek modelin araç seçiminin veya davranışının etkilenmesini hedefleyen saldırı yaklaşımıdır.
Tool Output Poisoning nedir?
Araçlardan dönen verilerin manipüle edilerek model davranışının etkilenmesini hedefleyen saldırı yaklaşımıdır.
AI Agent sistemlerinde Prompt Injection neden tehlikelidir?
AI Agent sistemleri gerçek araçlarla işlem gerçekleştirebilir. Bu nedenle model davranışının manipüle edilmesi operasyonel güvenlik etkisine dönüşebilir.
Human-in-the-Loop nedir?
Belirli yapay zekâ işlemlerinde insan değerlendirmesi veya onayının sürece dahil edilmesidir.
AI Agent için en önemli güvenlik kontrolü nedir?
Tek bir kontrol yeterli değildir. En az yetki, bağımsız yetkilendirme, veri güvenliği, işlem onayı ve sürekli güvenlik testi birlikte uygulanmalıdır.
AI Agent Pentest nedir?
AI Agent Pentest, yapay zekâ ajanlarının veri erişimi, araç kullanımı, yetkilendirme ve işlem güvenliğinin kontrollü saldırı senaryolarıyla değerlendirilmesidir.
MCP sunucuları güvenli midir?
MCP sunucularının güvenliği kaynağına, yapılandırmasına, yetkilerine ve uygulanan kontrollere bağlıdır. MCP kullanılması tek başına güvenlik garantisi sağlamaz.
AI Gateway AI Agent güvenliğinde kullanılabilir mi?
Evet. Ürün özelliklerine bağlı olarak merkezi politika, veri koruma, model erişimi ve belirli araç kullanım kontrollerini destekleyebilir.
Sonuç: Yapay Zekâ Ajanlarına Yetenek Kazandırırken Yetkilerini Sınırlandırmak Gerekir
AI Agent sistemleri, yapay zekâ teknolojilerinin kurumsal iş süreçlerine entegrasyonunda önemli bir aşamayı temsil ediyor.
Artık yapay zekâ yalnızca soruları cevaplamıyor.
Veri kaynaklarına bağlanıyor.
Rapor hazırlıyor.
İş akışları başlatıyor.
Araçlar kullanıyor.
Ve bazı durumlarda gerçek sistem işlemleri gerçekleştiriyor.
Bu gelişmeler verimlilik açısından önemli fırsatlar sunuyor.
Ancak güvenlik sorumluluğunu da artırıyor.
Çünkü bir modelin yanlış cevap üretmesiyle yanlış işlem gerçekleştirmesi aynı şey değildir.
Bir AI Agent'ın güvenli olması için yalnızca model davranışının kontrol edilmesi yeterli değildir.
Veri erişimleri sınırlandırılmalıdır.
Araç yetkileri tanımlanmalıdır.
MCP entegrasyonları değerlendirilmelidir.
Kimlik bilgileri korunmalıdır.
Kritik işlemler bağımsız yetkilendirmeden geçmelidir.
Gerekli durumlarda insan onayı uygulanmalıdır.
Ve bütün işlemler uygun şekilde izlenmelidir.
Özellikle Prompt Injection gibi tehditler karşısında temel güvenlik prensibi açık olmalıdır:
Modelin okuduğu bir doküman veya araç çıktısı, ajanın yetkilerini değiştirememelidir.
Güvenli AI Agent mimarisi, modelin her zaman doğru karar vereceği varsayımı üzerine kurulmaz.
Tam tersine, modelin hata yapabileceği veya manipüle edilebileceği kabul edilir.
Sistem buna rağmen güvenlik sınırlarını koruyacak şekilde tasarlanır.
Bu nedenle AI Agent güvenliğinin temel hedefi yapay zekânın yeteneklerini ortadan kaldırmak değildir.
Bu yetenekleri kontrollü ve denetlenebilir hale getirmektir.
Yapay zekâ ajanı akıllı olabilir; ancak hangi işlemleri yapabileceğine güvenilir güvenlik politikaları karar vermelidir.
İlgili Makaleler
Yazılım ve Yapay Zeka Güvenliği
Yazılım ve Yapay Zekâ Güvenliği Nedir? Modern Uygulamalarda Yeni Nesil Siber Tehditler
Yazılım ve yapay zekâ güvenliği nedir? LLM, AI Agent, Prompt Injection, veri sızıntısı, model güvenliği ve Secure AI SDLC risklerini keşfedin.
Yapay Zekâ ile Yazılım Geliştirmenin Güvenlik Riskleri: AI Kod Asistanları ve Güvenli Kod
Yapay zekâ ile yazılım geliştirmenin güvenlik risklerini keşfedin. AI kod asistanları, güvensiz kod üretimi, veri sızıntısı, SAST ve Secure Coding rehberi.
LLM Güvenliği Nedir? Büyük Dil Modellerine Yönelik Siber Saldırılar ve Korunma Yöntemleri
LLM güvenliği nedir? Büyük dil modellerinde Prompt Injection, veri sızıntısı, güvensiz çıktı işleme, model kötüye kullanımı ve kurumsal güvenlik önlemleri.
Prompt Injection ve Jailbreak Saldırıları: Yapay Zekâ Sistemleri Nasıl Manipüle Edilir?
Prompt Injection ve Jailbreak nedir? Doğrudan ve dolaylı saldırılar, RAG ve AI Agent riskleri, gerçekçi örnekler ve LLM güvenlik önlemlerini keşfedin.
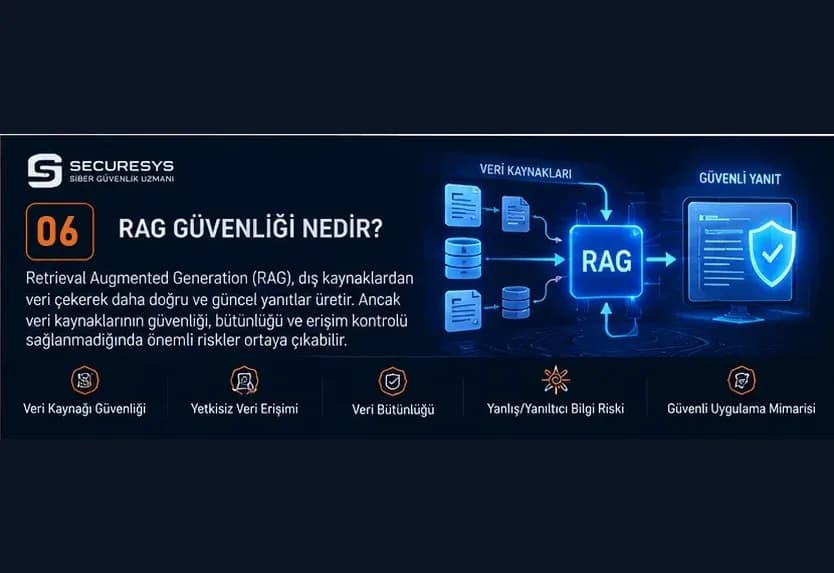
RAG Güvenliği Nedir? Vector Database, Doküman Zehirleme ve Kurumsal Veri Sızıntısı Riskleri
RAG güvenliği nedir? Retrieval-Augmented Generation, Vector Database, embedding, doküman zehirleme, Prompt Injection ve kurumsal veri sızıntısı risklerini öğrenin.
Shadow AI ve Kurumsal Veri Güvenliği: KVKK, GDPR ve Hassas Verilerin Yapay Zekâda Korunması
Shadow AI nedir? Çalışanların kontrolsüz yapay zekâ kullanımı, kurumsal veri sızıntısı, KVKK, GDPR, AI DLP, veri maskeleme ve AI Gateway güvenlik yöntemleri.
Bu konuda profesyonel destek mi arıyorsunuz?
Uzman ekibimiz ücretsiz danışmanlık için sizi en kısa sürede arasın.