AI Red Teaming ve LLM Pentest Nedir? Yapay Zekâ Uygulamalarında Güvenlik Testleri
AI Red Teaming ve LLM Pentest nedir? Prompt Injection, Jailbreak, RAG, AI Agent, MCP, veri sızıntısı ve model güvenliği testleriyle yapay zekâ sistemlerinin güvenliğini keşfedin.
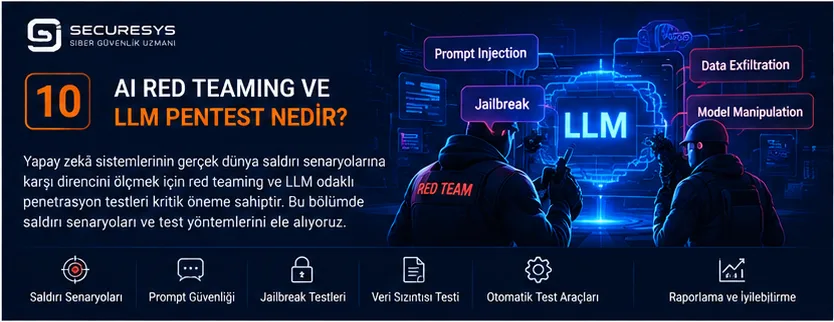
Giriş: Yapay Zekâ Sistemleri Gerçek Saldırı Senaryolarına Karşı Test Ediliyor mu?
Kurumsal yapay zekâ kullanımı hızla yaygınlaşıyor.
Şirketler müşteri destek süreçlerinde büyük dil modellerinden yararlanıyor.
Yazılım ekipleri kod asistanları kullanıyor.
Finans departmanları yapay zekâ destekli analiz sistemleri geliştiriyor.
İnsan kaynakları ekipleri doküman analizi gerçekleştiriyor.
Siber güvenlik operasyonlarında yapay zekâ destekli olay değerlendirme sistemleri kullanılıyor.
Ayrıca otonom AI Agent sistemleri, farklı kurumsal uygulamalar arasında işlem gerçekleştirebilecek şekilde tasarlanıyor.
Ancak bu gelişmeler önemli bir güvenlik sorusunu beraberinde getiriyor:
Yapay zekâ sistemlerinin güvenliği gerçekçi saldırı senaryolarıyla doğrulanıyor mu?
Bir yapay zekâ uygulamasının normal kullanıcı taleplerine doğru cevap vermesi, güvenli olduğu anlamına gelmez.
Model belirli girdiler karşısında güvenlik politikalarını ihlal edebilir.
Harici dokümanlardaki zararlı talimatlardan etkilenebilir.
Yetkisiz verilere erişmeye çalışabilir.
Hassas bilgileri çıktısına dahil edebilir.
Bağlı olduğu araçları yanlış parametrelerle çağırabilir.
Veya kullanıcı adına gerçekleştirmemesi gereken işlemleri başlatabilir.
Bu risklerin bir bölümü geleneksel uygulama güvenliği testleriyle tespit edilebilir.
Ancak yapay zekâ sistemlerinin olasılıksal davranışı, doğal dil üzerinden yönlendirilmesi ve harici veri kaynaklarıyla etkileşimi ek test yöntemlerini gerekli kılar.
AI Red Teaming ve LLM Pentest bu ihtiyaca cevap veren güvenlik değerlendirme yaklaşımlarıdır.
Bu makalede yapay zekâ sistemlerinin nasıl test edilmesi gerektiğini, hangi saldırı yüzeylerinin değerlendirilmesini ve sonuçların nasıl kurumsal güvenlik iyileştirmelerine dönüştürülmesini ele alacağız.
1. AI Red Teaming Nedir?
AI Red Teaming, yapay zekâ sistemlerinin güvenlik, güvenilirlik ve kötüye kullanım risklerini gerçekçi saldırgan davranışlarıyla değerlendirmeyi amaçlayan kontrollü test yaklaşımıdır.
Bu çalışmalarda yalnızca bilinen güvenlik açıkları aranmaz.
Sistemin farklı koşullarda nasıl davranacağı da incelenir.
Örneğin bir AI Red Team çalışmasında şu sorular değerlendirilebilir:
Model manipülatif girdiler karşısında güvenlik sınırlarını koruyabiliyor mu?
Harici veri kaynaklarındaki talimatları güvenilir komut gibi yorumluyor mu?
Yetkisiz bilgilere erişim sağlanabiliyor mu?
AI Agent, kullanıcı onayı olmadan kritik işlem gerçekleştirebiliyor mu?
Modelin çıktıları başka sistemlerde güvenlik problemi oluşturuyor mu?
Güvenlik kontrolleri farklı saldırı varyasyonları karşısında tutarlı çalışıyor mu?
AI Red Teaming, bu soruların kontrollü ve ölçülebilir testlerle cevaplanmasını hedefler.
AI Red Teaming yalnızca Prompt Injection testi değildir
Prompt Injection önemli bir saldırı kategorisidir.
Ancak kapsamlı bir AI Red Team çalışması veri güvenliği, model güvenliği, yetkilendirme, entegrasyonlar, araç çağrıları ve operasyonel kontrolleri de değerlendirebilir.
Bu nedenle AI Red Teaming, yapay zekâ uygulamasının tamamını kapsayan risk bazlı bir çalışma olarak ele alınmalıdır.
2. LLM Pentest Nedir?
LLM Pentest, büyük dil modeli kullanan uygulamaların güvenlik açıklarını ve kötüye kullanım risklerini kontrollü test senaryolarıyla değerlendiren sızma testi yaklaşımıdır.
LLM Pentest kapsamında hem geleneksel uygulama güvenliği hem de yapay zekâya özgü güvenlik riskleri incelenebilir.
Test kapsamına girebilecek bileşenler
LLM API entegrasyonu.
Kullanıcı arayüzü.
Prompt işleme mekanizması.
System Prompt ve uygulama talimatları.
RAG altyapısı.
Vector Database.
Doküman yükleme süreçleri.
AI Agent araçları.
MCP entegrasyonları.
Kimlik doğrulama.
Yetkilendirme.
Veri koruma kontrolleri.
Model çıktılarının işlendiği sistemler.
Bu bileşenler birlikte değerlendirilmediğinde uygulamanın gerçek güvenlik riski eksik anlaşılabilir.
3. AI Red Teaming ile LLM Pentest Arasındaki Fark
İki yaklaşım birbiriyle ilişkilidir ancak tamamen aynı değildir.
| Özellik | LLM Pentest | AI Red Teaming |
|---|---|---|
| Temel amaç | Güvenlik açıklarını belirlemek | Gerçekçi saldırı hedeflerine karşı dayanıklılığı ölçmek |
| Yaklaşım | Tanımlı test kapsamı ve kontroller | Tehdit odaklı senaryolar |
| Kapsam | LLM uygulaması ve entegrasyonları | Model, uygulama, süreç ve operasyonlar |
| Sonuç | Güvenlik bulguları ve iyileştirme önerileri | Saldırı yolları, güvenlik etkileri ve savunma değerlendirmesi |
| Test yöntemi | Manuel ve otomatik testler | Senaryo bazlı kontrollü saldırı simülasyonları |
Pratikte bu çalışmaların kapsamları örtüşebilir.
Örneğin kapsamlı bir LLM Pentest, AI Red Teaming senaryolarını içerebilir.
Benzer şekilde AI Red Teaming sırasında geleneksel sızma testi teknikleri kullanılabilir.
Önemli olan çalışmanın adından çok hedeflerin, yetkilerin, test kapsamının ve başarı kriterlerinin açıkça belirlenmesidir.
4. Geleneksel Pentest Yapay Zekâ Güvenliği İçin Yeterli midir?
Geleneksel pentest, yapay zekâ uygulamalarında önemli güvenlik açıklarını tespit edebilir.
Örneğin:
SQL Injection.
Broken Access Control.
Authentication problemleri.
API yetkilendirme hataları.
SSRF.
Güvensiz dosya yükleme.
Yanlış yapılandırılmış bulut servisleri.
Ancak bazı yapay zekâ riskleri geleneksel test metodolojilerinde yeterince ele alınmayabilir.
Örneğin:
Prompt Injection.
Jailbreak.
RAG doküman zehirleme.
AI Agent yetki aşımı.
Tool Calling manipülasyonu.
Model Extraction.
Model Inversion.
Adversarial Model Attacks.
Bu nedenle kurumsal yapay zekâ sistemleri için geleneksel uygulama güvenliği testlerinin yapay zekâya özgü testlerle desteklenmesi gerekir.
Yapay zekâ uygulaması bir yazılım sistemidir; ancak güvenlik değerlendirmesi yalnızca geleneksel yazılım açıklarıyla sınırlandırılmamalıdır.
5. AI Security Testing Kapsamı Nasıl Belirlenir?
Başarılı bir güvenlik testi öncelikle doğru kapsamın belirlenmesine bağlıdır.
Çünkü yapay zekâ sistemleri farklı mimarilerde çalışabilir.
Bazı uygulamalar yalnızca harici LLM API'si kullanır.
Bazıları kurum içi model çalıştırır.
Bazıları RAG mimarisiyle kurumsal dokümanlara erişir.
Bazıları ise AI Agent aracılığıyla farklı sistemlerde işlem gerçekleştirir.
Kapsam belirleme soruları
Hangi yapay zekâ modeli kullanılıyor?
Model kurum içinde mi çalışıyor?
Harici servis sağlayıcı bulunuyor mu?
RAG altyapısı mevcut mu?
Hangi veri kaynaklarına erişiliyor?
AI Agent kullanılıyor mu?
Tool Calling yetenekleri bulunuyor mu?
MCP sunucuları kullanılıyor mu?
Hangi kullanıcı rolleri mevcut?
Hangi hassas veriler işleniyor?
Model çıktıları otomatik işlemlere neden oluyor mu?
Bu sorular test planının oluşturulmasına yardımcı olur.
6. AI Threat Modeling Nedir?
AI Threat Modeling, yapay zekâ sisteminin saldırı yüzeylerinin, kritik varlıklarının ve güven sınırlarının sistematik biçimde değerlendirilmesidir.
Bu çalışma testlerden önce gerçekleştirilebilir.
Kritik varlıklar
Kullanıcı verileri.
System Prompt.
Model dosyaları.
Eğitim verileri.
API anahtarları.
RAG dokümanları.
Vector Database.
AI Agent yetkileri.
MCP entegrasyonları.
Kurumsal uygulama bağlantıları.
Güven sınırları
Kullanıcı ile uygulama arasındaki sınır.
Uygulama ile model arasındaki sınır.
Model ile araçlar arasındaki sınır.
RAG veri kaynağı ile model arasındaki sınır.
Agent ile kurumsal sistemler arasındaki sınır.
Bu sınırların belirlenmesi saldırı senaryolarının daha gerçekçi oluşturulmasını sağlar.
7. Prompt Injection Güvenlik Testleri
Prompt Injection, yapay zekâ sisteminin işlediği içeriklerde bulunan talimatlarla model davranışının manipüle edilmeye çalışılmasıdır.
LLM Pentest çalışmalarında önemli test alanlarından biridir.
Test hedefleri
Model güvenilmeyen içerikleri talimat olarak yorumluyor mu?
Kullanıcı girdileri sistem politikalarını etkileyebiliyor mu?
Harici dokümanlar model davranışını değiştirebiliyor mu?
Tool çıktıları güvenlik sınırlarını aşabiliyor mu?
Prompt Injection sonucunda yetkisiz işlem oluşuyor mu?
Test yaklaşımı
Öncelikle modelin normal davranışı belirlenir.
Ardından kontrollü manipülatif içerikler hazırlanır.
Sistemin bu içerikleri nasıl değerlendirdiği incelenir.
Başarılı ve başarısız senaryolar kayıt altına alınır.
Bulgular gerçek sistem etkisine göre değerlendirilir.
Önemli ayrım
Modelin beklenmeyen bir cümle üretmesi her zaman kritik güvenlik açığı anlamına gelmez.
Güvenlik etkisi, sistemin hangi verileri açıkladığına veya hangi işlemleri gerçekleştirdiğine göre belirlenmelidir.
8. Direct Prompt Injection Testleri
Direct Prompt Injection, saldırganın doğrudan kullanıcı girdisi üzerinden model davranışını etkilemeye çalışmasıdır.
Örneğin kullanıcı, uygulamanın tanımlı işlevi dışında bir davranış üretmesini hedefleyen talepler gönderebilir.
Test alanları
Talimat önceliği.
Uygulama politikaları.
Rol sınırları.
Hassas bilgi açıklama.
Araç kullanım yetkileri.
Çıktı kontrolü.
Test değerlendirmesi
Modelin yalnızca talebe cevap verip vermediği değil, uygulamanın güvenlik sınırlarını koruyup korumadığı incelenmelidir.
Örneğin yetkisiz veri erişimi modelin cevabıyla değil, backend yetkilendirme kontrolleriyle engellenmelidir.
9. Indirect Prompt Injection Testleri
Indirect Prompt Injection, modelin işlediği harici içerikler üzerinden davranışının etkilenmeye çalışılmasıdır.
Bu saldırı türü özellikle RAG ve AI Agent sistemlerinde önemlidir.
Test kaynakları
Web sayfaları.
PDF dokümanları.
E-postalar.
Veritabanı kayıtları.
Arama sonuçları.
Tool çıktıları.
RAG içerikleri.
Örnek senaryo
Bir kurumun doküman analiz asistanı PDF dosyalarını özetlemektedir.
Test kapsamında kontrol edilen bir PDF içerisine, dokümanın özetlenmesiyle ilgisiz bir talimat yerleştirilir.
Ardından sistemin bu talimatı veri olarak mı yoksa yürütülmesi gereken komut olarak mı değerlendirdiği incelenir.
Güvenlik hedefi
Güvenilmeyen doküman içeriğinin uygulamanın talimat hiyerarşisini veya işlem yetkilerini değiştirmemesi beklenir.
10. Jailbreak Güvenlik Testleri
Jailbreak, yapay zekâ modelinin davranış sınırlarını veya güvenlik kısıtlarını aşmaya yönelik manipülasyon girişimlerini ifade eder.
Jailbreak testleri modelin belirli politika sınırları karşısındaki dayanıklılığını değerlendirebilir.
Test alanları
Rol değiştirme girişimleri.
Çok aşamalı yönlendirme.
Bağlam manipülasyonu.
Dolaylı talimatlar.
Kodlanmış veya dönüştürülmüş içerikler.
Uzun konuşma bağlamı.
Değerlendirme
Testlerin sonucunda yalnızca modelin reddedip reddetmediği ölçülmemelidir.
Uygulamanın işlevi, veri erişimleri ve araç yetkileri de dikkate alınmalıdır.
Özellikle kritik kurumsal sistemlerde güvenlik yalnızca modelin davranışsal kısıtlarına bırakılmamalıdır.
11. System Prompt Disclosure Testleri
System Prompt, uygulamanın model davranışını yönlendirmek için kullandığı üst seviye talimatları içerebilir.
Bazı uygulamalarda sistem talimatlarının açıklanması istenmeyebilir.
Ancak System Prompt tek başına güvenli bir sır saklama mekanizması değildir.
Test hedefleri
Sistem talimatları beklenmeyen biçimde açıklanıyor mu?
Prompt içerisinde hassas bilgi bulunuyor mu?
API anahtarları veya kimlik bilgileri prompt içerisine eklenmiş mi?
Sistem talimatlarının açıklanması başka güvenlik etkilerine neden oluyor mu?
Güvenlik yaklaşımı
System Prompt içerisine erişim anahtarı veya parola eklenmemelidir.
Yetkilendirme kontrolleri backend üzerinde uygulanmalıdır.
Kritik güvenlik kararları modelin talimatlarına bırakılmamalıdır.
Bu nedenle System Prompt Disclosure bulguları gerçek güvenlik etkisiyle birlikte değerlendirilmelidir.
12. Sensitive Data Disclosure Testleri
Yapay zekâ uygulamalarında hassas veri açıklama riski önemli test alanlarından biridir.
Olası veri türleri
Kişisel veriler.
Müşteri bilgileri.
Finansal veriler.
Kaynak kod.
Ticari sırlar.
API anahtarları.
Kurumsal dokümanlar.
Test yaklaşımı
Test ortamında kontrollü ve sentetik veriler kullanılabilir.
Farklı kullanıcı rolleri oluşturulur.
Veri erişim sınırları belirlenir.
Modelin yetkisiz veri açıklayıp açıklamadığı değerlendirilir.
Önemli nokta
Gerçek kişisel verilerin gereksiz yere test ortamına aktarılmasından kaçınılmalıdır.
Testlerin kendisi de veri güvenliği yükümlülüklerine uygun yürütülmelidir.
13. RAG Security Testing Nedir?
RAG, Retrieval-Augmented Generation yaklaşımının kısaltmasıdır.
Modelin harici bilgi kaynaklarından getirilen içerikleri kullanarak cevap üretmesini sağlar.
RAG mimarisi kurumsal bilgiye erişim açısından faydalıdır.
Ancak yeni saldırı yüzeyleri oluşturur.
RAG test alanları
Doküman erişim kontrolü.
Retrieval yetkilendirmesi.
Vector Database güvenliği.
Doküman zehirleme.
Metadata manipülasyonu.
Kaynak doğrulama.
Hassas veri sızıntısı.
Indirect Prompt Injection.
Kritik güvenlik prensibi
Bir dokümanın retrieval sonucunda bulunabilmesi, kullanıcının o dokümana erişmeye yetkili olduğu anlamına gelmez.
Yetkilendirme, modelden bağımsız ve güvenilir uygulama katmanlarında uygulanmalıdır.
14. RAG Doküman Zehirleme Testleri
RAG sistemleri farklı veri kaynaklarından doküman alabilir.
Bu dokümanların güvenilirliği farklı olabilir.
Saldırganın kontrol ettiği içerikler retrieval sürecine dahil edilirse model davranışı etkilenmeye çalışılabilir.
Test senaryosu
Kontrollü bir doküman veri kaynağına eklenir.
Doküman içerisinde uygulamanın normal görevinden bağımsız talimatlar bulunur.
Sistemin dokümanı nasıl getirdiği ve nasıl yorumladığı incelenir.
Ölçülebilecek sonuçlar
Doküman retrieval sonucuna dahil edildi mi?
Model dokümandaki talimatı takip etti mi?
Hassas veri açıklaması oluştu mu?
Yetkisiz araç çağrısı gerçekleşti mi?
Güvenlik kontrolü olayı tespit etti mi?
Bu yaklaşım RAG güvenliğinin yalnızca model cevabıyla değil, veri ve işlem akışıyla birlikte değerlendirilmesini sağlar.
15. Vector Database Security Testing
Vector Database, embedding verilerinin saklanması ve benzerlik araması için kullanılabilir.
Ancak kurumsal sistemlerde vector database güvenliği de önemlidir.
Test alanları
Authentication.
Authorization.
Tenant isolation.
Collection erişimleri.
Metadata filtreleri.
API güvenliği.
Veri silme süreçleri.
Ağ erişimleri.
Örnek risk
Bir kullanıcının yalnızca kendi departmanına ait dokümanlara erişmesi gerekirken başka departmanın içerikleri retrieval sonucuna dahil olabilir.
Bu durumda model güvenlik politikasına uygun cevap vermeye çalışsa bile veri erişim sınırı zaten ihlal edilmiş olabilir.
Bu nedenle retrieval aşamasındaki yetkilendirme kontrolleri ayrıca test edilmelidir.
16. AI Agent Security Testing Nedir?
AI Agent sistemleri yalnızca cevap üretmekle sınırlı kalmayabilir.
Araç çağırabilir.
Dosya okuyabilir.
API kullanabilir.
İş akışlarını başlatabilir.
Kurumsal sistemlerde işlem gerçekleştirebilir.
Bu nedenle AI Agent güvenlik testleri model davranışının ötesine geçer.
Test hedefleri
Agent hangi araçlara erişebiliyor?
Hangi kullanıcı adına işlem yapıyor?
Yetkileri doğru sınırlandırılmış mı?
Kritik işlemler onay gerektiriyor mu?
Harici içerikler işlem kararlarını etkileyebiliyor mu?
Agent gereksiz veri aktarımı gerçekleştiriyor mu?
İşlem kayıtları tutuluyor mu?
Bu testler özellikle otonom işlem gerçekleştiren sistemlerde önemlidir.
17. Tool Calling Security Testing
Tool Calling, modelin tanımlı araçları çağırarak belirli işlemler gerçekleştirmesine imkân verir.
Örneğin bir AI Agent CRM sisteminden müşteri bilgisi alabilir.
Takvim kaydı oluşturabilir.
Destek talebi açabilir.
Veya belirli raporları hazırlayabilir.
Güvenlik riskleri
Yetkisiz araç çağrısı.
Aşırı yetkilendirme.
Parametre manipülasyonu.
Güvensiz API entegrasyonu.
Hassas veri aktarımı.
Kritik işlem onayının atlanması.
Test yaklaşımı
Araçların yetki matrisi oluşturulur.
Farklı kullanıcı rolleri tanımlanır.
Kritik işlem senaryoları belirlenir.
Modelin araç çağrıları izlenir.
Backend yetkilendirme kontrolleri doğrulanır.
Temel prensip
Modelin bir aracı çağırmak istemesi, o işlemin gerçekleştirilmesi için yeterli yetki anlamına gelmemelidir.
18. MCP Security Testing
MCP, Model Context Protocol ifadesinin kısaltmasıdır.
Yapay zekâ uygulamalarının araçlar ve veri kaynaklarıyla standartlaştırılmış biçimde etkileşmesini sağlayan bir protokoldür.
MCP entegrasyonları farklı güvenlik riskleri oluşturabilir.
Test alanları
MCP sunucu güvenliği.
Araç yetkilendirmesi.
Sunucu kimliği.
Tool metadata güvenilirliği.
Güvenilmeyen araç çıktıları.
Hassas veri erişimi.
Üçüncü taraf entegrasyonlar.
Önemli nokta
MCP kullanılması otomatik olarak güvenli kimlik doğrulama veya yetkilendirme sağlandığı anlamına gelmez.
Gerçek güvenlik seviyesi kullanılan mimariye, protokol özelliklerine ve uygulama kontrollerine bağlıdır.
Bu nedenle MCP sunucuları ve istemcileri ayrı ayrı değerlendirilmelidir.
19. Excessive Agency Testleri
Excessive Agency, yapay zekâ ajanının gereğinden geniş işlem yetkilerine sahip olmasıyla ilişkili güvenlik problemidir.
Örneğin bir raporlama asistanının yalnızca veri okuması gerekirken kayıt silme yetkisine sahip olması gereksiz risk oluşturabilir.
Test yaklaşımı
Agent'ın bütün araçları envantere alınır.
Her araç için gerekli yetki seviyesi belirlenir.
Kullanıcı rolleriyle karşılaştırılır.
Kritik işlemler için onay mekanizmaları değerlendirilir.
Yetkisiz işlem denemeleri kontrollü biçimde test edilir.
Korunma yaklaşımı
En az yetki prensibi uygulanmalıdır.
Okuma ve yazma yetkileri ayrılmalıdır.
Kritik işlemler bağımsız onay gerektirmelidir.
Backend politikaları uygulanmalıdır.
20. AI Agent Yetki Aşımı Senaryosu
Bir kurumun CRM sistemine bağlı yapay zekâ satış asistanı kullandığını düşünelim.
Asistanın görevi müşteri kayıtlarını özetlemek ve satış temsilcisine öneriler sunmaktır.
Ancak sistem teknik olarak müşteri kayıtlarını değiştirme yetkisine de sahiptir.
Test soruları
Agent bu yetkiyi kullanabiliyor mu?
Kullanıcı yetkisi kontrol ediliyor mu?
Harici içerikler Agent'ın işlem kararlarını etkileyebiliyor mu?
Kritik işlemler onay gerektiriyor mu?
Yetkisiz değişiklikler engelleniyor mu?
Beklenen güvenlik yaklaşımı
Agent yalnızca işlevi için gerekli yetkilere sahip olmalıdır.
Kritik değişiklikler güvenilir uygulama katmanında kontrol edilmelidir.
Kullanıcı onayı gereken işlemler bağımsız biçimde doğrulanmalıdır.
Bu senaryo modelin doğru davranmasına güvenmenin neden tek başına yeterli olmadığını gösterir.
21. Model Security Testing
AI Red Teaming çalışmaları bazı projelerde model seviyesindeki saldırıları da kapsayabilir.
Test alanları
Data Poisoning.
Adversarial Attacks.
Model Extraction.
Model Inversion.
Membership Inference.
Backdoor davranışları.
Model bütünlüğü.
Kapsam ayrımı
Her LLM Pentest çalışmasının bütün model güvenliği testlerini kapsaması gerekmez.
Örneğin yalnızca üçüncü taraf LLM API'si kullanan kurumun model ağırlıklarına veya eğitim verilerine erişimi bulunmayabilir.
Bu durumda test kapsamı uygulama ve entegrasyon seviyesinde sınırlandırılabilir.
Kurum içi model geliştiren organizasyonlarda ise daha kapsamlı model güvenliği değerlendirmeleri gerçekleştirilebilir.
22. Model Extraction Güvenlik Testleri
Model Extraction, modelin davranışını veya bazı özelliklerini sorgular üzerinden çıkarmayı hedefleyen saldırı yaklaşımıdır.
Test hedefleri
Model API'si kontrolsüz sorgulanabiliyor mu?
Kullanım kotaları mevcut mu?
Rate limiting uygulanıyor mu?
Anormal sorgu davranışları tespit ediliyor mu?
Gereksiz model bilgileri açıklanıyor mu?
Değerlendirme
Model Extraction riskinin değerlendirilmesi sırasında test sorgu sayıları ve kaynak tüketimi sınırlandırılmalıdır.
Üretim ortamının hizmet sürekliliği korunmalıdır.
Testler önceden tanımlanmış yetki ve kapsam dahilinde gerçekleştirilmelidir.
23. Adversarial Model Testing
Adversarial Model Testing, modelin manipülatif girdiler karşısındaki dayanıklılığının değerlendirilmesidir.
Bu testler model türüne göre farklılık gösterebilir.
Örnek alanlar
Görüntü sınıflandırma.
Anomali tespiti.
Dolandırıcılık tespiti.
İçerik sınıflandırma.
Büyük dil modelleri.
Değerlendirme kriterleri
Modelin normal performansı.
Manipülatif girdiler karşısındaki davranışı.
Yanlış pozitif oranı.
Yanlış negatif oranı.
Güvenlik kontrollerinin etkisi.
Gerçek iş sürecine olası etkisi.
Bu testler modelin kullanım amacına göre tasarlanmalıdır.
24. AI Red Teaming Metodolojisi
Kurumsal AI Red Teaming çalışmalarında yapılandırılmış metodoloji kullanılmalıdır.
Aşama 1: Kapsam ve yetkilendirme
Test edilecek sistemler belirlenir.
Yazılı yetkilendirme alınır.
Test sınırları tanımlanır.
Üretim ortamı kısıtları belirlenir.
Aşama 2: Mimari analizi
Model entegrasyonları incelenir.
Veri akışları belirlenir.
Araç ve servis bağlantıları değerlendirilir.
Aşama 3: Tehdit modelleme
Kritik varlıklar belirlenir.
Güven sınırları tanımlanır.
Olası saldırgan yetenekleri değerlendirilir.
Aşama 4: Test senaryoları
Prompt Injection.
Jailbreak.
RAG güvenliği.
Agent yetkilendirme.
Veri sızıntısı.
API güvenliği.
Model güvenliği.
gibi alanlarda senaryolar hazırlanır.
Aşama 5: Kontrollü test
Testler önceden belirlenmiş sınırlar içerisinde gerçekleştirilir.
Sistem davranışı gözlemlenir.
Kanıtlar kayıt altına alınır.
Aşama 6: Risk değerlendirmesi
Bulguların teknik etkisi ve iş etkisi değerlendirilir.
Aşama 7: Raporlama
Güvenlik bulguları, kanıtlar ve iyileştirme önerileri sunulur.
Aşama 8: Retest
Düzeltmeler sonrasında güvenlik kontrolleri yeniden doğrulanır.
25. AI Red Teaming İçin Test Matrisi
| Test alanı | Örnek güvenlik hedefi |
|---|---|
| Prompt Injection | Talimat sınırlarının korunması |
| Jailbreak | Davranış politikalarının dayanıklılığı |
| Sensitive Data Disclosure | Yetkisiz veri açıklamasının önlenmesi |
| RAG Security | Doküman erişim kontrolü |
| Vector Database | Tenant ve collection izolasyonu |
| AI Agent | İşlem yetkilerinin sınırlandırılması |
| Tool Calling | Araç çağrılarında yetkilendirme |
| MCP Security | Sunucu ve araç güvenliği |
| Model Extraction | Kontrolsüz model sorgulamasının azaltılması |
| API Security | Kimlik doğrulama ve yetkilendirme |
| Output Handling | Model çıktılarının güvenli işlenmesi |
| Monitoring | Şüpheli davranışların izlenmesi |
Bu matris örnek niteliğindedir.
Gerçek test kapsamı uygulamanın mimarisine ve risk seviyesine göre oluşturulmalıdır.
26. Otomatik LLM Güvenlik Testleri
LLM güvenlik testlerinde otomasyon kullanılabilir.
Örneğin belirli prompt varyasyonları sistematik biçimde test edilebilir.
Model cevapları karşılaştırılabilir.
Güvenlik kontrollerinin farklı girdiler karşısındaki davranışı ölçülebilir.
Otomasyonun avantajları
Tekrarlanabilir testler.
Geniş senaryo kapsamı.
Regresyon testi.
Model sürümleri arasında karşılaştırma.
Güvenlik politikası değişikliklerinin doğrulanması.
Sınırlamalar
Otomatik testler her zaman gerçek güvenlik etkisini doğru değerlendiremeyebilir.
Model cevapları olasılıksal olabilir.
Yanlış pozitif sonuçlar oluşabilir.
Bazı güvenlik problemleri iş süreci bağlamı gerektirir.
Bu nedenle otomasyon manuel analizle desteklenmelidir.
27. Manuel AI Red Teaming Neden Önemlidir?
Manuel testler sistemin iş mantığını ve kurumsal kullanım senaryolarını daha ayrıntılı değerlendirmeye yardımcı olabilir.
Örneğin otomatik bir test, modelin belirli ifadeyi üretip üretmediğini kontrol edebilir.
Ancak deneyimli bir güvenlik uzmanı şu soruları da değerlendirebilir:
Modelin cevabı gerçek yetki ihlali oluşturuyor mu?
Araç çağrısı gerçekleşti mi?
Hangi kullanıcı adına işlem yapıldı?
Backend kontrolü devreye girdi mi?
Veri gerçekten yetkisiz kişiye aktarıldı mı?
Güvenlik olayı loglandı mı?
Bu nedenle manuel testler özellikle karmaşık RAG ve AI Agent sistemlerinde önemlidir.
28. AI Red Teaming ve OWASP
OWASP, uygulama güvenliği alanında yaygın olarak kullanılan açık kaynak rehberler ve projeler sunar.
Büyük dil modeli uygulamalarına yönelik OWASP LLM Top 10 çalışmaları, yapay zekâ güvenlik risklerinin değerlendirilmesinde kullanılabilir.
Bu kapsamda:
Prompt Injection.
Hassas veri açıklama.
Tedarik zinciri riskleri.
Güvensiz çıktı işleme.
Aşırı yetkilendirme.
gibi konular değerlendirilebilir.
Ancak OWASP kategorileri tek başına eksiksiz test metodolojisi değildir.
Kurumun mimarisi ve iş süreçleri dikkate alınarak genişletilmelidir.
29. AI Red Teaming ve MITRE ATLAS
MITRE ATLAS, yapay zekâ sistemlerine yönelik saldırgan taktik ve tekniklerini değerlendirmek için kullanılabilen bilgi tabanıdır.
Bu yaklaşım AI Red Teaming senaryolarının yapılandırılmasına yardımcı olabilir.
Kullanım alanları
Tehdit modelleme.
Saldırı senaryosu oluşturma.
Güvenlik kontrol eşleştirme.
Test kapsamı analizi.
Savunma değerlendirmesi.
MITRE ATLAS, yapay zekâ güvenlik çalışmalarında tehdit odaklı bakış açısı sağlayabilir.
Ancak gerçek test senaryoları kurumun uygulama mimarisine göre uyarlanmalıdır.
30. AI Red Teaming ve NIST AI RMF
NIST AI Risk Management Framework, yapay zekâ risklerinin yönetilmesine yönelik çerçeve sunar.
AI Red Teaming bu risk yönetimi süreçlerini teknik doğrulama açısından destekleyebilir.
Örneğin kurum belirli yapay zekâ risklerini tanımlamış olabilir.
AI Red Teaming çalışması bu risklerin gerçek sistem üzerindeki etkisini değerlendirebilir.
Önemli ayrım
Risk yönetim çerçevesi oluşturmak ile teknik güvenlik testi gerçekleştirmek farklı faaliyetlerdir.
İkisi birlikte kullanıldığında daha kapsamlı güvenlik yaklaşımı oluşturulabilir.
31. AI Red Teaming Bulguları Nasıl Derecelendirilir?
Yapay zekâ güvenlik bulgularının derecelendirilmesi dikkatli yapılmalıdır.
Çünkü her beklenmeyen model cevabı aynı güvenlik etkisine sahip değildir.
Değerlendirme kriterleri
Saldırının ön koşulları.
Saldırganın erişim seviyesi.
Tekrarlanabilirlik.
Etkilenen veri türleri.
Yetkisiz işlem oluşup oluşmadığı.
İş etkisi.
Mevcut güvenlik kontrolleri.
Örnek risk seviyeleri
Kritik: Yetkisiz kullanıcıların kritik sistemlerde yüksek etkili işlemler gerçekleştirebilmesi.
Yüksek: Hassas verilere yetkisiz erişim veya önemli işlem yetkisi aşımı.
Orta: Belirli koşullarda güvenlik sınırlarının zayıflaması veya sınırlı veri açıklaması.
Düşük: Doğrudan güvenlik etkisi sınırlı olan yapılandırma veya davranış problemleri.
Bu sınıflandırma örnektir.
Gerçek risk seviyesi kurumun sistemine ve iş etkisine göre belirlenmelidir.
32. AI Red Teaming Raporu Nasıl Hazırlanmalıdır?
Profesyonel AI Red Teaming raporu yalnızca başarılı prompt örneklerinden oluşmamalıdır.
Teknik kanıtlar ve iş etkisi birlikte sunulmalıdır.
Önerilen rapor yapısı
Yönetici özeti
Testin amacı, kapsamı ve temel sonuçları.
Mimari değerlendirme
Test edilen model ve entegrasyon bileşenleri.
Metodoloji
Kullanılan test yaklaşımı ve referans çerçeveler.
Bulgular
Güvenlik problemlerinin teknik açıklamaları.
Kanıtlar
Test girdileri, sistem cevapları ve ilgili işlem kayıtları.
Risk değerlendirmesi
Olasılık, etki ve iş süreci ilişkisi.
İyileştirme önerileri
Teknik ve idari kontrol önerileri.
Retest sonuçları
Düzeltmelerin doğrulanması.
Bu yaklaşım raporun yalnızca teknik ekipler için değil, yönetim ve risk ekipleri için de kullanılabilir olmasını sağlar.
33. AI Red Teaming Sonrasında Ne Yapılmalıdır?
Güvenlik testi tamamlandıktan sonra bulguların kapatılması gerekir.
Ancak yapay zekâ sistemlerinde düzeltme yaklaşımı geleneksel yazılım sistemlerinden farklı olabilir.
Örneğin Prompt Injection problemi yalnızca System Prompt değiştirilerek kalıcı biçimde çözülemeyebilir.
Benzer şekilde modelin belirli cevabı reddetmesi, backend yetkilendirme problemini ortadan kaldırmaz.
İyileştirme alanları
Backend authorization.
Tool permission management.
RAG access control.
Data masking.
Input validation.
Output validation.
Human approval.
AI Gateway politikaları.
Logging ve monitoring.
Retest
Düzeltmeler sonrasında aynı senaryolar yeniden test edilmelidir.
Ayrıca değişikliklerin yeni güvenlik problemleri oluşturup oluşturmadığı değerlendirilmelidir.
34. AI Gateway Güvenlik Testlerinde Nasıl Değerlendirilir?
AI Gateway, yapay zekâ uygulamaları ile model servisleri arasındaki iletişimde merkezi kontrol katmanı olarak kullanılabilir.
Ancak bir güvenlik geçidinin bulunması, bütün risklerin ortadan kalktığı anlamına gelmez.
Test alanları
Hassas veri tespiti.
Veri maskeleme.
Prompt Injection kontrolleri.
Jailbreak kontrolleri.
Model erişim politikaları.
Tool Calling kontrolleri.
Onay mekanizmaları.
Audit logging.
Örnek değerlendirme
Belirli hassas veri içeren test girdileri hazırlanabilir.
Sistemin maskeleme veya engelleme politikaları doğrulanabilir.
Farklı prompt varyasyonlarıyla güvenlik kontrolünün tutarlılığı ölçülebilir.
Kritik araç çağrılarında onay mekanizmasının devreye girip girmediği incelenebilir.
Bu testler AI Gateway kontrollerinin gerçek uygulama akışındaki etkinliğini değerlendirmeyi sağlar.
35. Örnek Senaryo: Kurumsal Doküman Asistanı
Bir kurumun RAG tabanlı doküman asistanı kullandığını düşünelim.
Çalışanlar şirket politikalarını ve prosedürlerini bu sistem üzerinden sorgulamaktadır.
Test senaryosu 1: Yetkisiz doküman erişimi
Farklı kullanıcı rollerinin hangi dokümanlara erişebildiği değerlendirilir.
Test senaryosu 2: Indirect Prompt Injection
Kontrollü bir doküman üzerinden model davranışının etkilenip etkilenmediği incelenir.
Test senaryosu 3: Hassas veri açıklama
Modelin kullanıcıya yetkisiz veri sunup sunmadığı değerlendirilir.
Test senaryosu 4: Retrieval güvenliği
Metadata filtrelerinin ve erişim kontrollerinin doğru uygulanıp uygulanmadığı test edilir.
Test senaryosu 5: Audit logging
Şüpheli işlemlerin uygun biçimde kayıt altına alınıp alınmadığı değerlendirilir.
Bu örnek RAG güvenlik testlerinin model cevabının ötesinde veri erişim mimarisini de kapsaması gerektiğini gösterir.
36. Örnek Senaryo: SOC AI Agent
Bir kurumun SOC operasyonlarında yapay zekâ ajanı kullandığını düşünelim.
Agent güvenlik olaylarını analiz etmektedir.
SIEM kayıtlarını sorgulamaktadır.
Tehdit istihbaratı verilerini değerlendirmektedir.
Belirli koşullarda güvenlik operasyonlarına yönelik öneriler oluşturmaktadır.
Test senaryosu 1: Yetki sınırları
Agent'ın hangi sistemlere erişebildiği değerlendirilir.
Test senaryosu 2: Tool Calling
Araç çağrılarının doğru yetkilendirme kontrollerinden geçip geçmediği incelenir.
Test senaryosu 3: Harici veri manipülasyonu
Tehdit istihbaratı veya olay açıklamalarındaki güvenilmeyen içeriklerin Agent davranışını etkileyip etkilemediği test edilir.
Test senaryosu 4: Kritik işlem onayı
Agent'ın izolasyon veya engelleme gibi yüksek etkili işlemleri bağımsız onay olmadan gerçekleştirip gerçekleştiremediği değerlendirilir.
Test senaryosu 5: Denetim kayıtları
Agent'ın karar ve işlem akışlarının izlenebilirliği incelenir.
Bu senaryo AI Agent güvenliğinin özellikle operasyonel etki oluşturabilecek sistemlerde önemli olduğunu gösterir.
37. SECURESYS AI Red Teaming ve LLM Pentest Yaklaşımı
SECURESYS olarak yapay zekâ güvenliğinin yalnızca model cevaplarının kontrol edilmesiyle değerlendirilemeyeceğini düşünüyoruz.
Çünkü modern yapay zekâ sistemleri veri kaynakları, API servisleri, kurumsal uygulamalar ve otonom ajanlarla birlikte çalışıyor.
Bu nedenle güvenlik değerlendirmesi sistemin bütün mimarisini kapsamalıdır.
Proje kapsamına göre aşağıdaki alanlar değerlendirilebilir:
LLM Penetration Testing
Büyük dil modeli uygulamalarının güvenlik testleri.
Prompt Injection Assessment
Doğrudan ve dolaylı prompt manipülasyonu risklerinin değerlendirilmesi.
Jailbreak Resistance Testing
Model davranış sınırlarının kontrollü testlerle incelenmesi.
RAG Security Testing
Retrieval süreçleri, doküman güvenliği ve erişim kontrollerinin değerlendirilmesi.
AI Agent Security Testing
Otonom ajanların işlem yetkileri ve güvenlik sınırlarının incelenmesi.
MCP Security Assessment
MCP sunucuları, araçlar ve entegrasyonların güvenlik değerlendirmesi.
AI Model Security Testing
Model gizliliği, bütünlüğü ve adversarial dayanıklılığın değerlendirilmesi.
AI Gateway Security Validation
Merkezi yapay zekâ güvenlik kontrollerinin etkinliğinin test edilmesi.
AI Red Teaming
Gerçekçi saldırı senaryolarıyla yapay zekâ sistemlerinin güvenlik dayanıklılığının değerlendirilmesi.
Bu yaklaşımın temel amacı yalnızca güvenlik açıklarını belirlemek değildir.
Kurumların yapay zekâ sistemlerinin hangi koşullarda risk oluşturabileceğini anlamalarını ve güvenlik kontrollerini ölçülebilir biçimde iyileştirmelerini sağlamaktır.
Yapay zekâ güvenliğinde önemli olan yalnızca sistemin ne yapabildiğini değil, hangi koşullarda yapmaması gereken işlemleri gerçekleştirebildiğini de test etmektir.
38. AI Red Teaming Kontrol Listesi
Mimari ve kapsam
- Yapay zekâ mimarisi belirlendi mi?
- Model entegrasyonları incelendi mi?
- Veri kaynakları envantere alındı mı?
- AI Agent ve Tool Calling yetenekleri belirlendi mi?
Prompt güvenliği
- Direct Prompt Injection test edildi mi?
- Indirect Prompt Injection değerlendirildi mi?
- Jailbreak senaryoları uygulandı mı?
- System Prompt içerisinde hassas bilgi bulunuyor mu?
Veri güvenliği
- Hassas veri açıklama testleri yapıldı mı?
- Kullanıcı rolleri değerlendirildi mi?
- RAG erişim kontrolleri doğrulandı mı?
- Veri maskeleme politikaları test edildi mi?
Agent güvenliği
- Tool yetkileri sınırlandırıldı mı?
- MCP entegrasyonları değerlendirildi mi?
- Kritik işlemler onay gerektiriyor mu?
- Agent işlem kayıtları tutuluyor mu?
Model güvenliği
- Model Extraction riski değerlendirildi mi?
- Adversarial test ihtiyacı belirlendi mi?
- Model artifact güvenliği incelendi mi?
- Model API güvenliği test edildi mi?
Operasyonel güvenlik
- Güvenlik olayları izleniyor mu?
- Test sonuçları raporlandı mı?
- Bulgular için aksiyon planı oluşturuldu mu?
- Retest gerçekleştirildi mi?
Bu kontrol listesi kurumun yapay zekâ kullanım senaryosuna göre genişletilebilir.
Sık Sorulan Sorular
AI Red Teaming nedir?
AI Red Teaming, yapay zekâ sistemlerinin gerçekçi saldırı senaryolarına karşı güvenlik ve dayanıklılık açısından değerlendirilmesidir.
LLM Pentest nedir?
LLM Pentest, büyük dil modeli kullanan uygulamaların güvenlik açıklarının ve kötüye kullanım risklerinin kontrollü testlerle değerlendirilmesidir.
AI Red Teaming ile LLM Pentest arasındaki fark nedir?
LLM Pentest genellikle tanımlı uygulama güvenliği testlerine odaklanırken AI Red Teaming daha geniş tehdit ve saldırı senaryolarını kapsayabilir.
Geleneksel pentest yapay zekâ için yeterli midir?
Tek başına her zaman yeterli değildir. Yapay zekâya özgü Prompt Injection, RAG, Agent ve model güvenliği testleri de gerekebilir.
Prompt Injection testi nedir?
Modelin kullanıcı veya harici içeriklerdeki manipülatif talimatlardan etkilenip etkilenmediğinin değerlendirilmesidir.
Jailbreak testi nedir?
Modelin davranış sınırlarını aşmaya yönelik manipülasyon girişimlerine karşı dayanıklılığının değerlendirilmesidir.
RAG Security Testing nedir?
RAG mimarisindeki doküman erişimi, retrieval, veri güvenliği ve Prompt Injection risklerinin test edilmesidir.
AI Agent Security Testing nedir?
Yapay zekâ ajanlarının araç yetkileri, veri erişimleri ve kritik işlem kontrollerinin değerlendirilmesidir.
MCP Security Testing nedir?
MCP sunucularının, araçlarının ve entegrasyonlarının güvenlik açısından değerlendirilmesidir.
Model Extraction testi nedir?
Modelin davranışının kontrolsüz sorgularla çıkarılmasına karşı mevcut güvenlik kontrollerinin değerlendirilmesidir.
AI Red Teaming üretim ortamında yapılabilir mi?
Uygun yetkilendirme, kapsam, güvenlik sınırları ve operasyonel önlemlerle bazı testler üretim ortamında gerçekleştirilebilir. Yüksek riskli senaryolarda izole test ortamı tercih edilmelidir.
AI Red Teaming otomatik yapılabilir mi?
Bazı testler otomatikleştirilebilir. Ancak karmaşık güvenlik etkilerinin değerlendirilmesinde manuel analiz önemlidir.
AI Red Teaming ne sıklıkla yapılmalıdır?
Sıklık kurumun risk seviyesine ve sistem değişikliklerine göre belirlenmelidir. Önemli model, entegrasyon veya yetki değişikliklerinden sonra yeniden değerlendirme yapılması faydalıdır.
AI Red Teaming raporunda neler bulunmalıdır?
Kapsam, metodoloji, teknik bulgular, kanıtlar, risk derecelendirmesi, iyileştirme önerileri ve varsa retest sonuçları bulunmalıdır.
AI Gateway kullanılması LLM Pentest ihtiyacını ortadan kaldırır mı?
Hayır. AI Gateway belirli güvenlik kontrolleri sağlayabilir ancak uygulama, veri erişimi ve Agent yetkilendirme risklerinin ayrıca test edilmesi gerekir.
Sonuç: Yapay Zekâ Güvenliği Varsayımlarla Değil, Testlerle Doğrulanmalıdır
Yapay zekâ sistemleri giderek daha fazla kurumsal iş sürecine entegre ediliyor.
Modeller yalnızca cevap üretmiyor.
Dokümanlara erişiyor.
Veritabanlarını sorguluyor.
Kurumsal uygulamalarla iletişim kuruyor.
Araç çağırıyor.
Ve bazı durumlarda kullanıcı adına işlem gerçekleştiriyor.
Bu gelişmeler yapay zekâ sistemlerinin güvenlik etkisini artırıyor.
Bir modelin normal koşullarda doğru çalışması, saldırı koşullarında da güvenli davranacağı anlamına gelmez.
Prompt Injection saldırıları model davranışını etkileyebilir.
RAG sistemleri yetkisiz veri erişimi oluşturabilir.
AI Agent'lar gereğinden geniş yetkilere sahip olabilir.
MCP entegrasyonları yeni güven sınırları oluşturabilir.
Model API'leri kontrolsüz kullanıma açık olabilir.
Bu nedenle yapay zekâ güvenliği yalnızca politika dokümanları veya model sağlayıcısının güvenlik açıklamaları üzerinden değerlendirilmemelidir.
Gerçek sistem üzerinde kontrollü güvenlik testleri gerçekleştirilmelidir.
AI Red Teaming ve LLM Pentest çalışmaları kurumların bu riskleri anlamasına yardımcı olur.
Ancak testlerin etkili olması için kapsam doğru belirlenmelidir.
Mimari analiz yapılmalıdır.
Tehdit modeli oluşturulmalıdır.
Gerçekçi senaryolar hazırlanmalıdır.
Teknik kanıtlar toplanmalıdır.
Riskler iş etkisiyle birlikte değerlendirilmelidir.
Ve bulguların giderildiği retest ile doğrulanmalıdır.
Güvenli yapay zekâ, yalnızca güvenli olduğu düşünülen sistem değildir; güvenlik sınırları gerçekçi saldırı senaryolarıyla doğrulanmış sistemdir.
İlgili Makaleler
Yazılım ve Yapay Zeka Güvenliği
Yazılım ve Yapay Zekâ Güvenliği Nedir? Modern Uygulamalarda Yeni Nesil Siber Tehditler
Yazılım ve yapay zekâ güvenliği nedir? LLM, AI Agent, Prompt Injection, veri sızıntısı, model güvenliği ve Secure AI SDLC risklerini keşfedin.
Yapay Zekâ ile Yazılım Geliştirmenin Güvenlik Riskleri: AI Kod Asistanları ve Güvenli Kod
Yapay zekâ ile yazılım geliştirmenin güvenlik risklerini keşfedin. AI kod asistanları, güvensiz kod üretimi, veri sızıntısı, SAST ve Secure Coding rehberi.
LLM Güvenliği Nedir? Büyük Dil Modellerine Yönelik Siber Saldırılar ve Korunma Yöntemleri
LLM güvenliği nedir? Büyük dil modellerinde Prompt Injection, veri sızıntısı, güvensiz çıktı işleme, model kötüye kullanımı ve kurumsal güvenlik önlemleri.
Prompt Injection ve Jailbreak Saldırıları: Yapay Zekâ Sistemleri Nasıl Manipüle Edilir?
Prompt Injection ve Jailbreak nedir? Doğrudan ve dolaylı saldırılar, RAG ve AI Agent riskleri, gerçekçi örnekler ve LLM güvenlik önlemlerini keşfedin.
AI Agent Güvenliği: Otonom Yapay Zekâ, Tool Calling ve MCP Riskleri
AI Agent güvenliği nedir? Otonom yapay zekâ ajanlarında MCP, Tool Calling, Prompt Injection, yetki yükseltme, veri sızıntısı ve güvenli mimari yöntemlerini keşfedin.
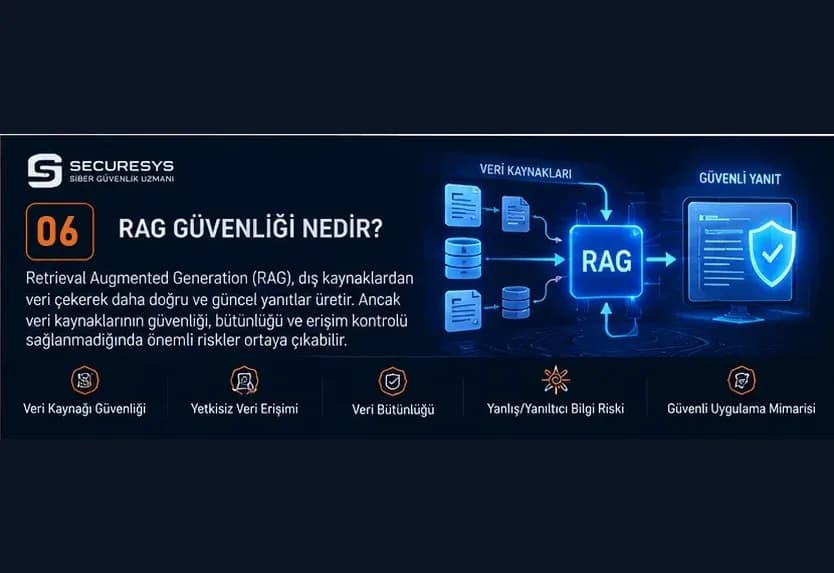
RAG Güvenliği Nedir? Vector Database, Doküman Zehirleme ve Kurumsal Veri Sızıntısı Riskleri
RAG güvenliği nedir? Retrieval-Augmented Generation, Vector Database, embedding, doküman zehirleme, Prompt Injection ve kurumsal veri sızıntısı risklerini öğrenin.
Bu konuda profesyonel destek mi arıyorsunuz?
Uzman ekibimiz ücretsiz danışmanlık için sizi en kısa sürede arasın.